大規模なシステムを運用していると、データ量の増加やアクセス集中、障害への備えなど、データ管理に関する課題が少しずつ積み重なっていきます。
特に、サービスの成長に伴ってデータベースへの負荷が高まると、「とりあえず動いている」状態から、可用性や性能、運用性まで考えた設計へ移行する必要があります。
そこで選択肢の一つになるのが、オープンソースのリレーショナルデータベースであるPostgreSQLです。
PostgreSQLは単にSQLを使ってデータを保存するための製品ではありません。
トランザクション処理、インデックス、レプリケーション、拡張機能などを備え、大規模なデータを長期的かつ安定して扱うための機能を幅広く提供しています。
では、実際にシステムを設計・開発するエンジニアの立場から見ると、PostgreSQLを導入することで何が変わるのでしょうか。
MySQLなどのほかのデータベースとの違いも意識しながら、性能だけではなく、データの整合性や障害対策、保守・運用まで含めて考えることが重要です。
本記事では、大規模システムにPostgreSQLを導入する際に注目したいポイントを整理します。
なぜPostgreSQLが選択肢になるのか、どのような機能がデータ管理の安定化につながるのか、そして導入時にどんな点へ注意すべきなのか。
データベースを「保存場所」としてではなく、システム全体を支える重要な基盤として捉えながら、エンジニア目線で詳しく見ていきます。
- 大規模システムのデータ管理でPostgreSQLが注目される理由
- PostgreSQLとは?大規模システムで使われるデータベースの特徴
- PostgreSQLの強み1:トランザクションとデータ整合性を確保できる
- PostgreSQLの強み2:インデックスとクエリ最適化で性能を高める
- PostgreSQLの強み3:レプリケーションで可用性と障害対策を強化する
- PostgreSQLの拡張性と豊富な機能が大規模システムに向いている理由
- PostgreSQLとMySQLを比較するときに確認したいポイント
- PostgreSQL導入時に注意したい設計・運用のポイント
- PostgreSQLを大規模システムへ導入する際の構成と運用方法
- PostgreSQLで大規模システムのデータ管理を安定させるために
大規模システムのデータ管理でPostgreSQLが注目される理由
大規模システムでは、ユーザー数やデータ量が増えるほど、データベースに求められる役割も大きくなります。
単純に大量のデータを保存できればよいわけではありません。
複数の処理が同時に走る環境でデータの整合性を保ち、障害が発生した場合にもサービスへの影響を抑えながら、将来的な機能追加やデータ量の増加にも対応する必要があります。
つまり、データベース選定では「動くか」だけでなく、長期間安定して運用できるかという視点が重要です。
その候補として注目されているのがPostgreSQLです。
PostgreSQLはオープンソースで開発されているリレーショナルデータベース管理システムで、SQLによるデータ操作を基本としながら、トランザクション、インデックス、外部キー、ビュー、ストアドプロシージャなど、業務システムで必要になる機能を幅広く備えています。
さらに、標準SQLを重視した設計や拡張性の高さも特徴です。
エンジニアの視点で特に重要なのは、PostgreSQLが単なる「データを保存する箱」ではなく、データの正しさをシステム側で担保するための仕組みを持っている点です。
たとえば、アプリケーションのバグや並行処理によってデータの不整合が発生すると、後から修正するコストは非常に大きくなります。
データベース側で制約やトランザクションを適切に設定しておけば、アプリケーションだけに整合性の責任を集中させずに済みます。
また、大規模システムでは「性能」と「安定性」を別々に考えないことも大切です。
アクセスが増えたときに処理速度が低下すれば、ユーザー体験だけでなく、APIやバックエンドの処理、場合によってはシステム全体の可用性にも影響します。
PostgreSQLではインデックスやクエリプランナーなどを活用して、データ量が増えた際の検索処理を効率化できます。
もちろん、これらの機能を導入すれば自動的に高速になるわけではなく、テーブル設計やSQL、実行計画を確認しながら適切にチューニングすることが前提です。
さらに、サービスを継続的に提供するには、障害への備えも欠かせません。
データベースサーバーの故障、ストレージ障害、誤操作など、データを失ったり利用できなくなったりする原因はさまざまです。
そのため、バックアップやリストア、レプリケーションといった仕組みを含めて設計する必要があります。
PostgreSQLはこうした運用を考えるための機能を備えており、オンプレミス環境だけでなく、クラウド上のデータベース基盤としても利用されています。
もう一つ見逃せないのが、PostgreSQLの拡張性です。
標準的なリレーショナルデータベースとして利用できるだけでなく、JSONBによる半構造化データの扱いや、全文検索、地理空間情報など、用途に応じた機能を追加できます。
すべてのデータを無理に単純な形式へ落とし込むのではなく、要件に合わせてデータモデルを設計できる点は、システムが複雑になるほどメリットになりやすいでしょう。
もちろん、PostgreSQLを導入すれば大規模システムの問題がすべて解決するわけではありません。
データベースの性能は、ハードウェア、ネットワーク、SQL、インデックス、アプリケーションの実装、接続数、運用設計など複数の要素によって決まります。
特に大規模環境では、データベース単体の性能だけを見るのではなく、システム全体のアーキテクチャの中でPostgreSQLをどう配置するかが重要です。
では、なぜ数あるデータベースの中からPostgreSQLを選択するのでしょうか。
ポイントになるのは、データの整合性、性能、拡張性、可用性、そして運用のしやすさを総合的に検討できることです。
特定の機能だけを評価するのではなく、サービスの要件と将来の成長を見据えて判断する。
この考え方こそ、大規模システムのデータ管理では重要になります。
以降では、PostgreSQLが備える具体的な機能を取り上げながら、なぜ大規模システムのデータ管理に適した選択肢になり得るのかを掘り下げていきます。
トランザクションによる整合性の確保、インデックスによる検索性能の改善、レプリケーションによる障害対策など、実際の設計や運用で意識したいポイントを順番に確認していきましょう。
PostgreSQLとは?大規模システムで使われるデータベースの特徴
PostgreSQLは、オープンソースで開発されているリレーショナルデータベース管理システムです。
アプリケーションからSQLを使ってデータを検索・追加・更新・削除できるだけでなく、データの整合性を保つための制約やトランザクション処理、複雑な検索を効率化するインデックスなど、業務システムの基盤として必要になる機能を幅広く備えています。
長年にわたって開発が続けられており、個人開発から企業の大規模システムまで、さまざまな用途で利用されている点も特徴です。
大規模システムでデータベースを選ぶ場合、単純な処理速度だけで判断するのは適切ではありません。
ユーザーやデータが増えたときに性能を維持できるか、複数の処理が同時に実行されてもデータの矛盾を防げるか、障害時に復旧できるか、さらに運用期間が長くなっても拡張しやすいか、といった複数の観点から評価する必要があります。
PostgreSQLは、このような要件を意識した設計を行いやすいデータベースです。
PostgreSQLはリレーショナルデータベースとしてデータを厳密に管理できる
PostgreSQLの基本となるのは、テーブル、行、列を使ってデータを構造化して管理するリレーショナルモデルです。
たとえばECサイトであれば、ユーザー、商品、注文、決済といった情報をそれぞれ適切なテーブルに分け、主キーや外部キーによってデータ同士の関係を定義できます。
こうした構造を明確にすることで、同じ情報を複数箇所に重複して保存することを避けやすくなり、データ更新時の不整合も抑えられます。
特に重要なのが、データベース側でルールを設定できることです。
NOT NULLやUNIQUE、CHECK、PRIMARY KEY、FOREIGN KEYといった制約を利用すれば、「この値は必須」「この値は重複してはいけない」「関連するデータが存在しなければならない」といった条件をデータベース自身に守らせることができます。
アプリケーションのコードだけで同じルールを管理するよりも、データの最終的な整合性を担保する仕組みをデータベースに持たせやすいわけです。
トランザクションによって複数の処理を一貫して扱える
大規模システムでは、複数のデータ更新を一つの処理として扱いたい場面が頻繁に発生します。
代表的なのがECサイトの注文処理です。
注文情報を登録したうえで在庫を減らす場合、注文だけ成功して在庫更新に失敗すると、実際の在庫数と注文状況に食い違いが生じます。
このような問題を防ぐために利用するのがトランザクションです。
PostgreSQLはACID特性を意識したトランザクション処理を提供しており、複数のデータ操作をまとめて成功させるか、問題が発生した場合には取り消す、といった制御が可能です。
もちろん、トランザクションを適切に設計するにはアプリケーション側の実装も重要です。
ロックの競合や長時間のトランザクションなどを放置すると、かえって性能上の問題につながるため、データベースの仕組みを理解したうえで利用する必要があります。
大規模なデータ量や同時アクセスを考慮した性能設計ができる
データ量が増えると、SQLを一度実行するだけでもデータベース内部で処理する量が大きくなります。
そこで重要になるのがインデックスやクエリプランナーです。
適切な列にインデックスを作成することで、テーブル全体を毎回確認する必要がなくなり、検索条件によっては大量のデータから必要なレコードを効率よく取得できます。
また、PostgreSQLはSQLの内容や統計情報などをもとに実行計画を作成し、クエリをどのように処理するかを判断します。
ただし、「PostgreSQLなら大量アクセスでも自動的に高速になる」と考えるのは危険です。
インデックスを増やしすぎれば更新処理の負荷が高くなりますし、SQLの書き方やデータ分布によっては期待した実行計画にならない場合もあります。
そのため、実際のシステムでは実行計画を確認し、処理時間やリソース使用量を計測しながらボトルネックを特定することが重要です。
データベースの性能は製品名だけで決まるものではなく、設計と運用によって大きく変わります。
拡張性と豊富なデータ型もPostgreSQLの特徴
PostgreSQLが大規模システムで検討される理由として、対応するデータ型や拡張機能の豊富さも挙げられます。
一般的な整数や文字列、日時などに加えて、配列やJSONBなども扱えるため、厳密に構造化されたデータと、ある程度柔軟な構造を持つデータを同じデータベース内で扱う設計も可能です。
特にJSONBは、Webアプリケーションで扱われる属性情報などを保存する用途で活用されています。
さらに、PostGISのような拡張機能を利用すれば、地理空間情報を扱うシステムにも対応できます。
このように標準的なリレーショナルデータベースの機能だけに限定されず、システムの要件に応じて機能を広げられることは、長期運用を前提としたシステムでメリットになります。
将来的に要件が変わったとき、データベースを別の仕組みに置き換えるのではなく、既存の基盤を活用しながら対応できる可能性があるためです。
オープンソースだからこそ導入時には運用設計が重要
PostgreSQLはOSSであるため、ライセンスコストやベンダーへの依存を抑えながら利用できることも特徴です。
一方で、OSSだから導入や運用にコストがかからないという意味ではありません。
大規模システムでは、バックアップ、監視、ログ管理、アップデート、障害対応、アクセス権限の管理などを継続的に行う必要があります。
特に重要なのが、障害が発生した場合にどこまで復旧できるのかを事前に定義しておくことです。
バックアップを取得するだけでは十分ではなく、実際にリストアできるかを検証し、目標復旧時間や許容できるデータ損失量に応じた構成を検討する必要があります。
レプリケーションなどの仕組みも、導入すること自体が目的ではありません。
システムの要件に合わせて、どの障害を想定し、どのように復旧するのかまで含めて設計することが重要です。
このように見ると、PostgreSQLの特徴は「高機能なデータベース」という一言だけでは表現しきれません。
データ整合性を守るための制約やトランザクション、大量データを扱うためのインデックスやクエリ最適化、用途を広げる豊富なデータ型と拡張機能、そして長期運用を支える周辺機能。
これらを組み合わせることで、大規模システムの要求に合わせたデータ管理基盤を構築できます。
一方で、どれだけ機能が豊富でも、システム要件に合っていなければ適切な選択とはいえません。
データ量、同時接続数、読み取りと書き込みの比率、可用性、バックアップ要件、運用体制などを整理したうえで、PostgreSQLの機能が本当に必要なのかを判断することが大切です。
では、実際の大規模システムで特に重要になる「データの整合性」について、PostgreSQLはどのような仕組みで支えているのでしょうか。
次はトランザクションとデータ整合性に焦点を当てて見ていきます。
PostgreSQLの強み1:トランザクションとデータ整合性を確保できる
大規模システムでデータベースを選定するとき、処理速度と同じくらい重要なのがデータの整合性です。
ユーザー情報、注文情報、在庫、決済履歴などが大量に保存される環境では、一部の処理だけが成功して別の処理が失敗すると、データ同士の関係が崩れてしまいます。
こうした不整合は、単なる表示上の問題にとどまらず、二重注文や在庫数の誤り、請求金額の不一致など、サービスそのものの信頼性に影響する問題へ発展する可能性があります。
そこで重要になるのが、PostgreSQLが提供するトランザクション処理です。
トランザクションとは、複数のデータ操作をひとまとまりの処理として扱う仕組みです。
たとえばECサイトで注文を受け付ける場合、「注文レコードを登録する」「在庫を減らす」「決済に必要な情報を記録する」といった処理が考えられます。
これらを別々の処理として扱うのではなく、一連の処理として管理することで、途中でエラーが発生した場合に変更を取り消し、処理前の整合した状態へ戻すことができます。
トランザクションの基本となるACID特性
PostgreSQLのトランザクションを理解するうえで知っておきたいのがACID特性です。
ACIDは、原子性(Atomicity)、一貫性(Consistency)、独立性(Isolation)、永続性(Durability)の4つの性質を表しています。
データベースにおけるトランザクション処理の信頼性を考えるための基本的な概念です。
原子性は、トランザクション内の処理を「すべて成功」または「すべて失敗」として扱う性質です。
注文登録と在庫更新を同じトランザクションに含めた場合、在庫更新で問題が起きたにもかかわらず注文登録だけが残る、といった状態を避けやすくなります。
アプリケーション側で個別に後処理を実装するよりも、データベースの仕組みを利用して一貫した状態を維持できることがポイントです。
一貫性は、トランザクションの前後でデータベースが定義された整合性ルールを満たすことを意味します。
たとえば主キーの重複を許さない、外部キーで指定された関連データを適切に維持するといった制約を利用できます。
重要なのは、整合性をアプリケーションのプログラムだけに任せないことです。
複数のアプリケーションやバッチ処理から同じデータベースへアクセスする環境では、データベース自身がルールを強制できることに大きな意味があります。
複数ユーザーによる同時更新でもデータの矛盾を防ぐ
大規模システムでは、一人のユーザーがデータベースを操作しているわけではありません。
数百、数千、場合によってはそれ以上のリクエストが同時に発生し、同じテーブルや同じレコードへアクセスすることもあります。
ここで問題になるのが、複数の処理が同時に同じデータを更新する際の競合です。
たとえば、在庫が1個しかない商品に対して、ほぼ同時に2件の注文が入ったとします。
アプリケーションが単純に「現在の在庫数を取得して1を引く」という処理だけを行うと、2つの処理が同じ在庫数を読み取ってしまい、意図しない結果になる可能性があります。
このような並行処理の問題を考えるとき、データベースのトランザクション分離やロックの仕組みが重要になります。
PostgreSQLでは、トランザクション分離レベルやロックなどを利用して、同時実行される処理の関係を制御できます。
ただし、ロックを使えば使うほど安全になるという単純な話ではありません。
必要以上に広い範囲をロックすると、別の処理が待たされて性能低下につながることがあります。
さらに、複数の処理が互いにロック解除を待つ状態になれば、デッドロックが発生する可能性もあります。
したがって、整合性と性能のバランスを考えたトランザクション設計が欠かせません。
制約によってデータベース自身にルールを守らせる
データ整合性を高めるうえでは、トランザクションだけでなくデータベースの制約も重要です。
PostgreSQLでは、PRIMARY KEY、UNIQUE、NOT NULL、CHECK、FOREIGN KEYなどの制約を設定できます。
これらを適切に使うことで、アプリケーションの実装ミスによって不正なデータが登録されるリスクを抑えられます。
たとえば、ユーザーを識別するIDを主キーとして設定すれば、同じIDを持つ複数のレコードが登録されることを防げます。
メールアドレスの重複を許可したくない場合にはUNIQUE制約を利用できます。
また、商品の価格が負の値になってはいけないのであれば、CHECK制約によって値の条件を定義することも可能です。
注文とユーザーの関係を外部キーで表現すれば、存在しないユーザーに対する注文データを登録するといった矛盾も防止できます。
この考え方は、ソフトウェア設計における「正しい状態をどこで保証するか」という問題につながります。
アプリケーションだけで検証することもできますが、複数のサービスやバッチ、管理ツールなどから同じデータベースへアクセスする場合、すべての入口で同じ検証を実装する必要があります。
データベースに重要な制約を持たせれば、アクセス経路が増えても一定のルールを維持できます。
PostgreSQLのトランザクションを活かすには設計が重要
ここまで見ると、PostgreSQLのトランザクション機能を使えばデータ整合性の問題を簡単に解決できるように感じるかもしれません。
しかし、実際のシステムではトランザクションの範囲をどこに設定するかが非常に重要です。
トランザクションを長時間維持すると、ロックやリソースの保持によって他の処理へ影響を与える可能性があります。
逆に、必要な処理を別々のトランザクションに分割しすぎると、一連の業務処理としての一貫性を保てなくなることがあります。
そのため、設計段階では「どの操作を一つのトランザクションとして扱うべきか」を業務上の単位から考える必要があります。
注文処理、口座間の資金移動、在庫更新など、途中の状態を外部から見せたくない処理は特に慎重な設計が求められます。
また、トランザクションの失敗を想定して、アプリケーション側で適切にロールバックやエラーハンドリングを行うことも必要です。
大規模システムにおいてデータベースの安定性を考えるなら、単に「PostgreSQLはトランザクションに対応している」と理解するだけでは不十分です。
ACID特性、分離レベル、ロック、制約、トランザクションの範囲といった仕組みを理解し、それぞれをシステム要件に合わせて使い分けることが重要です。
特にデータの正しさが直接ビジネス上の価値や信頼性につながるシステムでは、この設計思想が大きな意味を持ちます。
そして、整合性を維持できても、データ量が増えたときに検索処理が遅くなれば、ユーザーから見たシステムの品質は低下します。
大規模システムでは「正しいデータを扱えること」と「必要なデータを素早く取得できること」の両方が求められるわけです。
次はPostgreSQLのインデックスやクエリ最適化に注目し、大量のデータを効率よく検索するための仕組みを見ていきましょう。
PostgreSQLの強み2:インデックスとクエリ最適化で性能を高める
大規模システムでは、データ量の増加に伴って「検索に時間がかかる」という問題が起こりやすくなります。
数千件程度のデータではほとんど気にならなかったSQLが、数百万件、数千万件のレコードを扱うようになると、同じ処理でも応答時間が大きく変わることがあります。
特にWebアプリケーションでは、1回のリクエストでデータベースへの問い合わせが複数回発生することもあるため、個々のSQLの遅延が積み重なると、システム全体のレスポンスにも影響します。
このような性能問題を考えるうえで重要なのが、PostgreSQLのインデックスとクエリ最適化です。
インデックスは検索対象のデータを効率よく見つけるための仕組みであり、クエリ最適化では、SQLを実行する際にどのようなアクセス方法を選ぶかが判断されます。
つまり、単に高性能なサーバーを用意するだけではなく、データベースが効率的にデータへアクセスできる構造を設計することが重要になります。
インデックスによって大量データから必要な情報を探しやすくする
インデックスを理解するために、書籍の索引をイメージすると分かりやすいでしょう。
数百ページある本から特定のキーワードを探す場合、最初のページから最後まで一枚ずつ確認するよりも、索引から該当ページを探したほうが効率的です。
データベースのインデックスも基本的には同じ発想で、検索条件に適したインデックスが存在すれば、テーブル全体を確認せずに目的のレコードへ到達しやすくなります。
たとえばユーザーIDやメールアドレス、注文日時などを検索条件として頻繁に利用するシステムでは、これらの列に適切なインデックスを設定することで検索性能の改善が期待できます。
特にレコード数が大きくなるほど、インデックスの有無が処理時間に与える影響は無視できません。
開発初期の少量データでは問題なくても、本番環境でデータが蓄積された途端にSQLが遅くなるケースもあるため、将来的なデータ量を考慮した設計が必要です。
ただし、インデックスは多ければ多いほどよいわけではありません。
インデックス自体もストレージ上に保持するデータ構造であり、INSERTやUPDATE、DELETEが発生した際にはインデックスの更新も必要になります。
不要なインデックスを大量に作成すると、書き込み処理の負荷やストレージ使用量が増加する可能性があります。
そのため、実際のアクセスパターンを確認しながら、検索頻度と更新頻度のバランスを考えて設計することが重要です。
PostgreSQLのクエリプランナーがSQLの実行方法を判断する
PostgreSQLで性能を考える際には、インデックスを作成するだけでなく、SQLが実際にどのように実行されているのかを確認する必要があります。
PostgreSQLにはクエリプランナーがあり、テーブルの統計情報などを利用して、どのような実行計画でSQLを処理するかを判断します。
たとえばインデックスを利用する方法とテーブルを順番に読み取る方法のどちらが効率的なのかを、データ量や条件などから判断します。
ここで重要なのは、「インデックスを作ったから必ず使われる」とは限らないことです。
対象となるデータが非常に多く、検索条件に該当するレコードも大量に存在する場合、インデックスを経由するよりテーブルをまとめて読み取ったほうが効率的なケースがあります。
データベースは常に人間の期待どおりの方法を選択するわけではなく、統計情報などをもとに実行計画を決定します。
そのため、性能問題が発生した場合には、SQLの見た目だけを確認するのではなく、実際の実行計画を調査することが重要です。
PostgreSQLではEXPLAINやEXPLAIN ANALYZEを利用して、SQLがどのような計画で実行され、各処理にどの程度の時間がかかっているのかを確認できます。
これによって、想定していたインデックスが利用されているのか、テーブル全体を読み取っていないか、結合処理に時間がかかっていないかなどを具体的に分析できます。
SQLの書き方とデータベース設計も性能を左右する
データベースの性能改善というと、インデックスを追加することだけに目が向きがちです。
しかし、実際にはSQLそのものやテーブル設計も大きく関係します。
必要以上に大量の列を取得したり、不要なレコードまで取得してアプリケーション側で絞り込んだりすれば、データベースだけでなくネットワークやアプリケーション側にも余計な負荷がかかります。
また、複数のテーブルを結合するSQLでは、結合条件やデータ量によって処理コストが大きく変わります。
正規化されたテーブルを適切に設計しつつ、実際の検索パターンに応じてインデックスを検討することが基本です。
一方で、読み取り性能を優先するために無計画な非正規化を行うと、データ更新時の整合性管理が難しくなる場合があります。
ここでも、性能だけを単独で追うのではなく、保守性やデータ整合性とのバランスが必要です。
大規模システムでは、SQLの性能を開発者の経験や勘だけに頼らないことも重要です。
実際のデータ量やアクセスパターンを想定した負荷試験を行い、処理時間、CPU、メモリ、ディスクI/Oなどを計測することで、どこがボトルネックになっているのかを客観的に判断できます。
これはPostgreSQLに限らず、データベースを長期運用するうえで基本となる考え方です。
インデックス設計では読み取りと書き込みのバランスを考える
Webサービスでは、検索や一覧表示などの読み取り処理が多いシステムもあれば、ログ収集やイベント記録など大量の書き込みが中心になるシステムもあります。
前者では検索性能を高めるためのインデックスが有効になりやすい一方、後者ではインデックスを増やしすぎることで書き込み処理への負荷が問題になる可能性があります。
さらに、大規模なテーブルでは、単一列だけでなく複数列を組み合わせた複合インデックスが有効になる場合もあります。
ただし、複合インデックスにも列の順序などを考慮する必要があります。
どの検索条件で利用されるのかを明確にせず、思いつきでインデックスを追加しても期待した効果は得られません。
実際のSQLとデータ分布を確認し、目的を明確にしたうえで設計することが重要です。
PostgreSQLの性能を安定させるには継続的な監視が欠かせない
大規模システムでは、データベースの性能は一度チューニングすれば終わりというものではありません。
サービスの利用者が増えればデータ量もアクセスパターンも変化します。
昨日まで高速だったSQLが、数か月後にはボトルネックになることもあります。
そのため、スロークエリの監視や実行時間の計測、リソース使用量の確認などを継続的に行う必要があります。
重要なのは、性能改善を「速くする作業」だけとして考えないことです。
どの処理が遅いのかを計測し、なぜ遅いのかを実行計画やデータ量から分析し、変更後に本当に改善したのかを再び計測する。
このサイクルを回すことで、根拠のあるチューニングが可能になります。
特に大規模システムでは、体感だけで判断せず、メトリクスやログなどの客観的な情報をもとに改善する姿勢が重要です。
PostgreSQLのインデックスとクエリ最適化は、大量のデータを扱うシステムの性能を支える重要な仕組みです。
ただし、インデックスを増やすだけで問題が解決するわけではありません。
テーブル設計、SQL、データ量、アクセスパターン、実行計画、そして継続的な監視まで含めて考える必要があります。
性能問題をデータベース単体の問題ではなく、システム全体の設計課題として捉えることがポイントです。
そして大規模システムでは、性能だけでなく、サーバー障害が発生した場合にもサービスとデータを守れる構成が求められます。
どれだけ高速に検索できても、データベースが停止すればアプリケーションの処理も止まってしまいます。
次はPostgreSQLのレプリケーションに注目し、可用性を高めるための仕組みと障害対策について見ていきましょう。
PostgreSQLの強み3:レプリケーションで可用性と障害対策を強化する
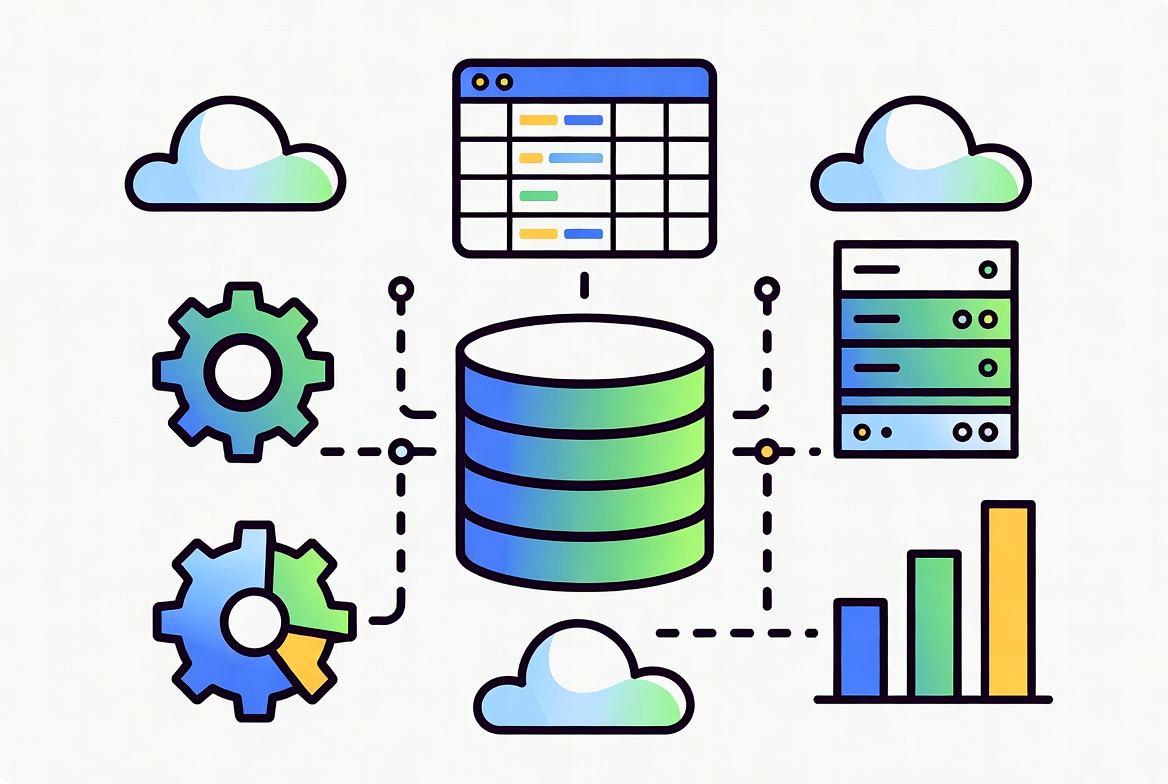
大規模システムでは、データベースを「止めない」ための設計も重要なテーマです。
アプリケーションサーバーを複数台用意して負荷分散していても、データベースが1台だけで、そのサーバーに障害が発生すれば、サービス全体が利用できなくなる可能性があります。
特に注文、決済、会員情報などの重要なデータを扱うシステムでは、障害発生時にどれだけ短時間でサービスを復旧できるかが、運用上の重要な指標になります。
そこで検討したいのが、PostgreSQLのレプリケーションです。
レプリケーションとは、データベースのデータを別のサーバーへ複製する仕組みです。
代表的な構成として、更新処理を担当するプライマリと、そのデータを受け取るスタンバイを用意する方法があります。
プライマリに障害が発生した場合にスタンバイへ切り替えられる構成を整えておけば、単一サーバーに障害が集中するリスクを低減できます。
PostgreSQLのストリーミングレプリケーションとは
PostgreSQLでは、ストリーミングレプリケーションを利用して、プライマリサーバーからスタンバイサーバーへWAL(Write-Ahead Logging)を転送し、変更内容を複製できます。
WALは、データベースに対する変更を記録する仕組みで、障害からの復旧やレプリケーションを支える重要な要素です。
スタンバイ側では受け取ったWALを適用することで、プライマリに近い状態を維持します。
この構成のポイントは、単純にデータを定期コピーするのとは異なることです。
データベースの変更情報を継続的に転送するため、バックアップとは異なる目的で利用できます。
たとえば、プライマリの障害に備えて別サーバーにデータを同期しておき、必要に応じてスタンバイを昇格させるといった構成が可能です。
もちろん、実際の切り替えには監視やフェイルオーバーの設計が必要であり、レプリケーションを設定しただけで完全な自動復旧環境になるわけではありません。
レプリケーションとバックアップは役割が異なる
ここで注意したいのが、「レプリケーションしているからバックアップは不要」と考えないことです。
レプリケーションは主にサーバー障害などへの備えとして有効ですが、誤ったデータ更新や削除まで複製される可能性があります。
たとえば、管理者が誤って大量のレコードを削除した場合、その変更がスタンバイにも反映されれば、レプリケーションだけでは元の状態へ戻せません。
そのため、大規模システムではレプリケーションとバックアップを別の仕組みとして考えることが重要です。
バックアップは、障害だけでなく、誤操作やデータ破損なども含めて、過去の時点の状態へ復旧するための手段として設計します。
一方、レプリケーションは、障害発生時に別のデータベースサーバーへ処理を切り替え、サービス停止時間を短縮するための手段として考えると整理しやすいでしょう。
高可用性を実現するにはフェイルオーバーまで設計する
レプリケーションを導入するだけでは、高可用性は完成しません。
重要なのは、プライマリに障害が発生したときに「誰が」「どのように」「どのタイミングで」スタンバイへ切り替えるのかを決めておくことです。
この切り替えをフェイルオーバーと呼びます。
たとえば、監視システムがプライマリの障害を検知し、正常なスタンバイを新しいプライマリとして利用する構成が考えられます。
しかし、自動化すれば必ず安全になるわけではありません。
ネットワーク障害によって一時的に通信できないだけなのか、本当にサーバーが停止しているのかを正しく判断できなければ、不要な切り替えが発生する可能性があります。
複数のサーバーが同時にプライマリとして動作する状態を避けるためにも、フェイルオーバーの条件や運用ルールを慎重に設計する必要があります。
また、切り替え後にはアプリケーション側の接続先も考慮しなければなりません。
データベースの役割が変わっても、アプリケーションが古い接続先へアクセスし続ければサービスは復旧しません。
ロードバランサーやDNS、接続プールなど、周辺のインフラまで含めて切り替えを設計する必要があります。
高可用性はデータベース単体の機能ではなく、システム全体で作るものと考えることが重要です。
同期レプリケーションと非同期レプリケーションの違い
レプリケーション方式を検討するときには、同期と非同期の違いも重要です。
非同期レプリケーションでは、プライマリ側の処理を先に完了させ、WALの変更内容を後からスタンバイへ送ります。
そのため、プライマリの処理性能への影響を抑えやすい一方、障害発生時にスタンバイへまだ届いていない変更が失われる可能性があります。
一方、同期レプリケーションでは、指定したスタンバイ側で変更が確認されることを待ってからトランザクションを完了させる構成が可能です。
データ損失のリスクを抑えられる反面、スタンバイやネットワークの状態がプライマリ側の処理性能や可用性に影響する可能性があります。
どちらが適切かは、システムが許容できるデータ損失量や応答性能、ネットワーク構成などによって変わります。
障害対策では、「絶対にデータを失わない」と「どんな状況でも高速に処理する」を同時に実現できるとは限りません。
そこで、RPO(Recovery Point Objective)とRTO(Recovery Time Objective)を定義し、どこまでのデータ損失を許容するのか、どれくらいの時間で復旧する必要があるのかを明確にすることが大切です。
技術的な機能から構成を決めるのではなく、業務要件から必要な可用性を逆算する考え方です。
読み取り負荷の分散にもレプリケーションを活用できる
レプリケーションは障害対策だけでなく、読み取り処理の負荷分散にも活用できます。
たとえば、更新処理はプライマリで実行し、参照系の処理を読み取り可能なスタンバイへ振り分ける構成です。
検索や一覧表示など、読み取り処理が非常に多いWebサービスでは、プライマリに集中する負荷を分散できる可能性があります。
ただし、レプリカ側のデータがプライマリと完全に同時刻の状態とは限りません。
非同期レプリケーションでは、変更がスタンバイへ反映されるまでに遅延が発生する可能性があります。
そのため、「直前に更新したデータを必ず直後の検索で取得する」といった処理をレプリカへ無条件に振り分けると、期待した結果にならない場合があります。
どの処理をどのデータベースへ向けるのか、データの鮮度に関する要件まで含めて設計する必要があります。
障害対策では実際の復旧手順を検証する
高可用性の設計でありがちな落とし穴は、「構成図では復旧できるが、実際には復旧できない」という状態です。
レプリケーションが正常に動作していても、障害時の切り替え手順が整理されていなかったり、バックアップからのリストア方法を誰も検証していなかったりすれば、実運用では大きな問題になります。
そのため、定期的に障害を想定した訓練を行うことが重要です。
プライマリ停止、ネットワーク障害、ストレージ障害、誤操作など、想定する障害ごとに復旧手順を確認し、実際にどの程度の時間でサービスを復旧できるのかを計測します。
手順書だけを作成して終わりにするのではなく、実際の環境で検証することがポイントです。
また、レプリケーションの状態を監視することも欠かせません。
スタンバイが存在していても、WALの転送や適用が停止していれば、障害発生時に期待した状態へ復旧できない可能性があります。
レプリケーション遅延や接続状態などを監視し、異常が発生した場合に早期に検知できる仕組みを整える必要があります。
PostgreSQLのレプリケーションは、大規模システムの可用性を高めるうえで有力な仕組みです。
しかし、本当に重要なのは「レプリケーションを導入した」という事実ではありません。
バックアップ、監視、フェイルオーバー、アプリケーションの接続先、復旧訓練まで含めて設計し、障害が発生したときに実際にサービスを復旧できる状態を作ることです。
ここまで見てきたように、PostgreSQLはデータの整合性を守るだけでなく、大量データを効率的に処理し、障害に備えるための仕組みも備えています。
さらに、用途に応じた拡張機能を組み合わせることで、より複雑なシステム要件にも対応できます。
次はPostgreSQLの拡張性と豊富な機能に焦点を当て、大規模システムで長期的に利用する際のメリットを見ていきましょう。
PostgreSQLの拡張性と豊富な機能が大規模システムに向いている理由
大規模システムでは、導入時点の要件だけでなく、数年後にどのような機能が必要になるかまで考えてデータベースを選ぶ必要があります。
サービスが成長すれば、保存するデータの種類は増え、検索方法も複雑になります。
最初はユーザー情報と注文情報だけだったシステムに、ログ解析、位置情報、柔軟な属性データ、全文検索などが追加されることも珍しくありません。
こうした変化に対して、データベースをその都度別の製品へ置き換えるのは、移行コストや障害リスクを考えると簡単ではありません。
PostgreSQLが大規模システムで評価される理由の一つが、こうした将来的な要件変更に対応しやすい拡張性です。
基本となるリレーショナルデータベースの機能に加えて、JSONB、配列、全文検索、各種インデックス、拡張機能などを組み合わせられます。
つまり、単純なCRUD処理だけを行うデータベースとして使うのではなく、システムの要件に応じてデータ処理の能力を広げられる基盤として利用できるわけです。
JSONBによって柔軟なデータ構造にも対応できる
PostgreSQLの機能で特にWebアプリケーションとの相性がよいものの一つがJSONBです。
リレーショナルデータベースでは、基本的にテーブルの列を定義してデータ構造を明確にします。
一方、Webサービスではユーザーや商品によって属性が異なるなど、すべての項目を固定的な列だけで表現することが難しいケースがあります。
このような場合にJSONBを利用すると、JSON形式のデータをPostgreSQL内に保存し、内容を検索・操作できます。
たとえば商品ごとに異なる追加属性を持たせたい場合、すべてを個別の列として追加するのではなく、JSONBにまとめて管理する設計が考えられます。
アプリケーション側でJSONを扱う機会が多い現在のWeb開発では、データベースとアプリケーションの間でデータ形式を変換する負担を抑えられる点もメリットです。
ただし、JSONBを使えば何でも自由に設計してよいわけではありません。
頻繁に検索・集計するデータまでJSONBへ詰め込むと、リレーショナルな構造を利用したほうが分かりやすく、制約も設定しやすい場合があります。
重要な業務データをすべて柔軟なJSONとして保存すると、データ構造が曖昧になり、後から保守するエンジニアが苦労することもあります。
固定的で重要な属性は通常の列として管理し、変動しやすい補助的な属性にJSONBを利用するなど、用途に応じた使い分けが重要です。
豊富なデータ型によって用途に合わせたデータ設計ができる
PostgreSQLは標準的な数値、文字列、日時などのデータ型だけでなく、配列やJSONB、UUIDなど、さまざまなデータ型を扱えます。
データベース設計では「とりあえず文字列として保存する」のではなく、データの性質に合った型を選ぶことが重要です。
適切な型を使えば、入力値の扱いを明確にでき、比較や検索などの処理もデータベースの機能を活用しやすくなります。
たとえばシステム内で一意な識別子としてUUIDを採用する場合、文字列として扱うだけでなくUUID型を利用できます。
また、複数の値をまとめて管理する必要があるケースでは配列型が選択肢になります。
もちろん、便利なデータ型を無条件に利用するのではなく、アプリケーションとの連携やインデックス設計、将来的なデータ移行まで考えて採用することが大切です。
このような型の豊富さは、単に開発者が選べる機能が多いという話ではありません。
データの意味をデータベースのスキーマに反映できるということです。
データモデルを明確に表現できれば、後からシステムを引き継ぐエンジニアにとっても理解しやすくなります。
大規模システムほど、こうした「データの意味を構造として表現する」設計が保守性に影響します。
拡張機能によって専門的なデータ処理にも対応できる
PostgreSQLでは、標準機能だけでは対応しにくい用途に対して拡張機能を利用できることも大きな特徴です。
代表例として知られているのがPostGISで、地理空間情報を扱うシステムで利用されています。
地図サービスや位置情報を利用するアプリケーションでは、単純な緯度・経度の数値を保存するだけではなく、「ある地点から一定距離以内の店舗を検索する」といった空間的な処理が必要になります。
こうした処理をPostgreSQLの拡張機能で実現できる点は、専門的な要件を持つシステムにとって有用です。
また、PostgreSQLには拡張機能を追加する仕組みが用意されており、必要な機能を組み合わせて利用できます。
これは、すべてのシステムが同じ構成になることを意味しません。
むしろ、必要な機能だけを選択し、データベースをシステムの要件に合わせて構成できることに価値があります。
一方で、拡張機能を採用する際には依存関係にも注意が必要です。
OSSの拡張機能だから簡単に追加できると考えるのではなく、PostgreSQLのバージョンアップへの対応状況、運用環境との互換性、バックアップやリストアへの影響などを確認する必要があります。
大規模システムでは、導入時の便利さだけでなく、数年後の保守まで含めて判断することが重要です。
全文検索やインデックスを活用して検索機能を強化できる
大規模なサービスでは、単純な完全一致検索だけでなく、文章や説明文などを対象とした検索機能が必要になることがあります。
PostgreSQLには全文検索のための機能があり、データベース内でテキストを検索する仕組みを構築できます。
外部の検索システムを必ず別途導入しなければならないとは限らないため、システム規模や検索要件によっては構成をシンプルにできる可能性があります。
もちろん、検索機能の要件が高度になれば、専用の検索エンジンを採用したほうが適している場合もあります。
大量の文書を対象とした複雑なランキングや検索分析など、データベースの責務を超えてくる要件もあるためです。
ここでも重要なのは、「PostgreSQLだけですべてを実現する」という発想ではありません。
PostgreSQLで十分な要件なのか、それとも専用サービスを組み合わせるべきなのかを、性能や運用コストを含めて判断することです。
大規模システムでは拡張性と保守性をセットで考える
拡張性が高いデータベースは便利ですが、機能を増やせば増やすほどシステムが良くなるわけではありません。
むしろ、大規模システムでは「使える機能」と「実際に使う機能」を明確に分けることが重要です。
複数の拡張機能や特殊なデータ型を無計画に導入すると、設計が複雑になり、障害調査やバージョンアップの難易度が高くなる可能性があります。
たとえば、JSONBで保存できるからという理由だけで、すべての業務データをJSONB化するのは適切とは限りません。
リレーショナルモデルで表現したほうが制約を設定しやすいデータと、柔軟な構造が必要なデータを分離することで、PostgreSQLの機能をより合理的に利用できます。
設計時には「この機能が使えるか」だけではなく、「なぜこの機能を使うのか」「数年後もこの設計を維持できるか」という問いを持つことが大切です。
また、データベースの拡張性を評価するときには、開発者の生産性だけでなく運用担当者の視点も必要です。
監視しやすいか、バックアップできるか、障害時に復旧できるか、アップデート時に問題が起きないか。
大規模システムでは、開発フェーズよりも運用期間のほうが長くなることも珍しくありません。
したがって、導入時の機能の豊富さだけでなく、長期的なライフサイクル全体を見て判断する必要があります。
PostgreSQLを「万能なデータベース」と考えないことが重要
ここまで紹介したように、PostgreSQLには豊富な機能があります。
しかし、それを理由に「PostgreSQLだけでシステムのすべてを解決できる」と考えるのは適切ではありません。
キャッシュにはRedisなどの専用システム、複雑な全文検索には検索エンジン、巨大な分析処理にはデータウェアハウスなど、用途によって適した技術は異なります。
重要なのは、PostgreSQLをシステムの中心となるデータ基盤として利用しながら、必要に応じて周辺の技術と組み合わせることです。
PostgreSQLの豊富な機能は、外部サービスをすべて置き換えるためのものではなく、システムの要件に対して選択肢を増やすためのものと考えると分かりやすいでしょう。
大規模システムでは、将来的な要件変更に対応できる柔軟性と、現在の構成を安全に運用できるシンプルさの両方が求められます。
PostgreSQLの拡張性は、そのバランスを検討するうえで有力な材料になります。
データ型、JSONB、全文検索、拡張機能などを適切に組み合わせれば、システムの成長に合わせてデータ基盤を発展させることができます。
ここまで見てきたように、PostgreSQLにはデータ整合性を守るトランザクション、大量データを効率的に検索するためのインデックス、障害に備えるレプリケーション、そして要件の変化に対応する拡張性があります。
一方で、機能を導入するだけで安定したシステムになるわけではなく、設計と運用が重要です。
では、実際にPostgreSQLを大規模システムへ導入するとき、ほかの代表的なデータベースであるMySQLとはどのような違いを確認すればよいのでしょうか。
次は両者を比較するときの具体的なポイントを整理します。
PostgreSQLとMySQLを比較するときに確認したいポイント
PostgreSQLを大規模システムへ導入するか検討するとき、比較対象としてよく挙げられるのがMySQLです。
どちらも広く利用されているリレーショナルデータベースであり、SQLを使って構造化されたデータを管理できます。
そのため、「どちらが優れているか」という単純な比較をするよりも、システムの要件に対して、どちらの特徴が適しているかという視点で整理することが重要です。
特に大規模システムでは、データベースの機能だけでなく、既存システムとの互換性、開発チームの経験、クラウドサービスでの利用環境、運用体制、将来的な拡張性なども選定に影響します。
性能についても、ベンチマークの数字だけを見るのではなく、自分たちのデータ量やSQL、同時アクセス数を想定して評価する必要があります。
PostgreSQLとMySQLはどちらもリレーショナルデータベース
まず押さえておきたいのは、PostgreSQLとMySQLはどちらもリレーショナルデータベース管理システムであるという点です。
テーブルや行、列を使ってデータを構造化し、SQLによってデータを操作するという基本的な考え方は共通しています。
Webアプリケーションのバックエンドや業務システムなど、幅広い用途で利用できる点も共通しています。
一方で、細かな機能やSQLの実装、データ型、拡張機能、運用方法などには違いがあります。
既存のアプリケーションがどちらかを前提として設計されている場合、単純にデータベースだけを入れ替えるのは難しいケースもあります。
特にSQL方言や関数、インデックス、トランザクションの扱いなど、アプリケーションとデータベースの間には多くの依存関係が存在します。
したがって、新規システムなら要件に合わせて比較し、既存システムなら移行によってどの程度の修正が発生するのかまで確認することが重要です。
製品そのものだけでなく、システム全体との相性を見る必要があります。
データ型やSQL機能の違いを確認する
PostgreSQLは、標準SQLへの対応を重視しながら、豊富なデータ型や高度なSQL機能を提供していることが特徴です。
JSONB、配列、UUIDなどを扱えるほか、ウィンドウ関数や共通テーブル式など、複雑なデータ処理をSQL側で実現するための機能も充実しています。
大規模な業務システムで複雑なデータモデルや検索要件がある場合、こうした機能が設計上の選択肢になります。
MySQLも一般的なWebアプリケーションや業務システムに必要な機能を幅広く備えていますが、両者では利用できる機能や構文、挙動に違いがあります。
そのため、PostgreSQLからMySQLへ、あるいはMySQLからPostgreSQLへ移行する場合には、SQLを単純に置き換えれば済むとは限りません。
使用している関数やデータ型、制約、インデックスなどを確認する必要があります。
特に大規模システムでは、データベース固有の機能を多用しているほど移行コストが大きくなる傾向があります。
逆に言えば、新規開発の段階で特定のデータベースへ依存する機能を採用する場合、そのメリットと将来的な移行コストをセットで考えることが重要です。
性能比較ではベンチマークの数字だけを見ない
PostgreSQLとMySQLの比較で特に注意したいのが性能です。
インターネット上にはさまざまなベンチマーク結果がありますが、その数値だけを見て「こちらのほうが高速」と判断するのは危険です。
データベースの性能は、データ量、テーブル構造、インデックス、SQL、読み取りと書き込みの比率、同時接続数、ハードウェアなどによって大きく変化するためです。
たとえば、単純な読み取り処理が中心のシステムと、複雑なJOINや集計処理が多いシステムでは、同じデータベースでも負荷のかかり方が異なります。
また、書き込みが大量に発生するログ基盤と、ユーザーが検索するECサイトでは、最適なデータベース構成も変わります。
そのため、性能を比較する場合は、自分たちのシステムに近い条件でテストすることが重要です。
実際のテーブル構造や代表的なSQL、想定するデータ量、同時実行数などを再現し、レスポンスタイムやスループット、CPU、メモリ、ディスクI/Oなどを測定します。
性能は製品名ではなく、ワークロードとの組み合わせで評価するという考え方が基本です。
データ整合性とトランザクションの要件を比較する
業務システムでは、処理速度だけでなくデータの正しさが重要です。
注文と在庫、決済と請求など、複数のデータを一貫して更新する必要がある処理では、トランザクションやロック、制約の設計が重要になります。
PostgreSQLとMySQLはいずれもトランザクションを扱えますが、細かな挙動や設定、ストレージエンジンなどの違いを考慮する必要があります。
特にMySQLでは、現在一般的に利用されるInnoDBがトランザクション、外部キー、行レベルロックなどを提供しています。
PostgreSQLにもトランザクションやMVCCを利用した並行処理の仕組みがあります。
ここで大切なのは、機能名だけを比較するのではなく、実際の業務処理を想定して検証することです。
たとえば、同じ在庫データに対して多数の注文が同時に発生する場合、どのような分離レベルやロック方式が必要になるのかを確認します。
データベースの選定時点でこのようなシナリオを検証しておけば、本番環境で同時実行による問題が発生するリスクを抑えやすくなります。
拡張性や特殊なデータ処理を比較する
PostgreSQLとMySQLの違いを考えるうえでは、基本的なCRUD処理以外に何が必要なのかも重要です。
PostgreSQLにはJSONB、配列、全文検索、PostGISなど、用途を広げるための機能や拡張機能があります。
複雑なデータ処理や特殊なデータ形式を扱うシステムでは、これらが設計上の選択肢になります。
一方、MySQLもWebアプリケーションのバックエンドとして長く利用されており、PHPやRubyなどのWeb開発環境をはじめ、多くのフレームワークやツールから利用できます。
既存の開発チームがMySQLに慣れている場合、技術的な学習コストや運用ノウハウの蓄積を考慮する必要があります。
ここでも「機能が多いほうを選ぶ」と単純化しないことがポイントです。
使わない機能が大量にあっても、それだけでシステム上のメリットになるわけではありません。
必要な機能を明確にし、その機能をどちらのデータベースで無理なく実現できるのかを比較するほうが合理的です。
クラウド環境と運用方法もデータベース選定に影響する
現在の大規模システムでは、データベースを自前のサーバーに構築するだけでなく、クラウド上のマネージドサービスを利用するケースも増えています。
そのため、PostgreSQLとMySQLを比較するときには、データベースそのものの機能だけでなく、利用予定のクラウドサービスがどちらをどの程度サポートしているかも確認する必要があります。
マネージドサービスを利用すれば、バックアップ、監視、パッチ適用、レプリケーションなどの運用作業をサービス側へ任せられる場合があります。
ただし、利用できる拡張機能や設定項目にはサービスごとの制約があることもあります。
オンプレミス環境では自由に利用できた機能が、マネージド環境では制限される可能性もあるため、導入前の確認が重要です。
また、データベースを運用するエンジニアのスキルも無視できません。
PostgreSQLに詳しいチームとMySQLに詳しいチームでは、同じ製品でも運用上の負担が異なります。
障害対応や性能チューニングを含めて考えると、社内に蓄積されている知識や外部の運用支援を受けられる環境も選定材料になります。
PostgreSQLとMySQLの比較はシステム要件から行う
結局のところ、PostgreSQLとMySQLのどちらを採用するかを判断するときに重要なのは、製品の優劣を一律に決めることではありません。
確認すべきポイントをシステム要件に合わせて整理することです。
- データ量と将来的な増加量をどの程度想定しているか
- 読み取りと書き込みの比率はどの程度か
- SQLやデータ型にどの程度の高度な機能が必要か
- データ整合性やトランザクションにどのような要件があるか
- レプリケーションやバックアップなど、どの程度の可用性が必要か
- オンプレミスとクラウドのどちらで運用するのか
- 開発・運用チームが持っている知識や経験はどちらに近いか
これらを整理してから、実際のワークロードを使って検証するのが合理的です。
特に大規模システムでは、開発環境で正常に動くことと、本番環境で長期間安定して運用できることは別問題です。
性能試験、障害試験、バックアップからのリストア試験などを実施し、技術面と運用面の両方から確認する必要があります。
PostgreSQLは、高度なSQL機能や豊富なデータ型、拡張性などを活用したいシステムにおいて検討しやすい一方、MySQLにも長年の利用実績や幅広いエコシステムがあります。
重要なのは、こうした特徴を理解したうえで、自分たちのシステムが必要とする条件と照らし合わせることです。
データベース選定は製品の比較で終わるのではなく、設計、開発、運用まで含めたアーキテクチャの選択として考えると整理しやすくなります。
ここまででPostgreSQLの基本的な強みと、MySQLとの比較ポイントを確認しました。
では、実際にPostgreSQLを採用することになった場合、どのような点に注意して設計・運用すればよいのでしょうか。
次は、データベースの性能だけではなく、バックアップや監視、セキュリティなども含めた導入時の注意点を見ていきます。
PostgreSQL導入時に注意したい設計・運用のポイント
PostgreSQLは高機能なデータベースですが、導入するだけで大規模システムが安定するわけではありません。
むしろ重要なのは、データ量やアクセスパターンを踏まえてテーブルを設計し、適切なインデックスを設定し、障害や性能劣化を想定した運用体制まで含めて構成することです。
データベースはアプリケーションの土台になるため、初期設計の小さな判断が、数年後の運用コストや障害対応に大きく影響します。
特に注意したいのが、「開発環境では問題なく動いている」という状態を、本番環境でも安定して動くと考えてしまうことです。
データ量、同時接続数、トランザクションの競合、バックアップ時間などは、本番環境になると大きく変わります。
そこでPostgreSQLを導入するときは、機能を使えるかどうかだけでなく、増え続けるデータをどう管理し、障害が起きたときにどう復旧するかまで考えておく必要があります。
最初にデータモデルとテーブル設計を固める
PostgreSQLを導入する際、最初に確認したいのがデータモデルです。
どのような情報をどのテーブルに保持し、テーブル同士をどのキーで関連付けるのか。
ここが曖昧なまま開発を進めると、後からデータの重複や不整合が発生しやすくなります。
たとえばユーザー情報を複数のテーブルに重複して保存すると、ユーザー名を変更したときに更新漏れが起きる可能性があります。
一方で、すべてのデータを過度に正規化すると、参照時のJOINが複雑になり、読み取り性能やクエリの保守性に影響する場合もあります。
重要なのは、正規化そのものを目的にするのではなく、データの整合性とアクセス性能のバランスを考えることです。
また、主キーや外部キー、UNIQUE、NOT NULL、CHECKなどの制約も積極的に検討します。
アプリケーション側だけで「この値は必ず存在する」「この組み合わせは重複しない」と管理するより、データベース側にもルールを持たせたほうが、複数のアプリケーションやバッチ処理からアクセスされた場合でも整合性を維持しやすくなります。
インデックスはアクセスパターンを見て設計する
大規模システムではインデックス設計も重要です。
インデックスを適切に設定すれば検索対象を効率よく絞り込めますが、単純に「検索する列にはすべてインデックスを付ける」という考え方は危険です。
インデックスもデータベース上の構造であるため、追加・更新・削除の際にはメンテナンスコストが発生します。
たとえば書き込みが非常に多いテーブルに大量のインデックスを設定すると、読み取りは速くなっても書き込み処理の負荷が増える可能性があります。
また、複合インデックスでは列の順序によって利用されやすいクエリが変わります。
実際にどのSQLが実行されるのかを確認し、実行計画を見ながら設計することが重要です。
さらに、本番環境ではデータ量が増えることで、開発時には問題にならなかったクエリが急に遅くなることがあります。
そのため、EXPLAINなどを使って実行計画を確認し、実際のデータ量に近い環境で性能を検証しておくことが重要です。
インデックスは一度作って終わりではなく、アプリケーションの成長に合わせて見直すものと考えたほうがよいでしょう。
接続数とトランザクションの管理を適切に行う
大規模システムで意外と見落とされやすいのが、データベースへの接続管理です。
アプリケーションサーバーの台数が増えると、それぞれが大量のDB接続を確保しようとする可能性があります。
接続数が増えすぎれば、PostgreSQL側のメモリ消費や処理負荷が増え、新しい接続を受け付けられなくなることもあります。
そのため、アプリケーション側ではコネクションプールを利用するなど、DB接続を適切に管理することが重要です。
単に「最大接続数を増やせばよい」と考えるのではなく、アプリケーションサーバーの台数、各プロセスの接続数、SQLの実行時間などを合わせて設計します。
必要に応じて接続プールの導入も検討したいところです。
トランザクションについても同様です。
トランザクションを長時間保持すると、ロックやMVCCに関連する問題が発生しやすくなります。
特に、ユーザーからの入力待ちや外部APIへの通信など、時間のかかる処理をDBトランザクションの中に含める設計は慎重に考える必要があります。
トランザクションは必要な処理だけを短くまとめるという原則が、大規模システムでは特に重要です。
バックアップとリストアを必ず検証する
データベース運用では、「バックアップを取得しているから安心」と考えてしまいがちです。
しかし、本当に重要なのは、必要なときにデータを復旧できることです。
バックアップファイルが存在していても、復元手順が確立されていなかったり、復元に想定以上の時間がかかったりすれば、障害対応では十分に機能しません。
PostgreSQLを運用する場合は、どの時点までデータを復旧できればよいのか、どれくらいの時間でサービスを復旧する必要があるのかを事前に整理します。
いわゆるRPOとRTOです。
これらを決めておけば、バックアップの頻度やWALの扱い、レプリケーション構成などを具体的に検討しやすくなります。
そして、定期的なリストアテストも必要です。
バックアップが正常に作成されていることと、実際にそのバックアップからPostgreSQLを復元できることは別問題だからです。
復旧手順をドキュメント化し、担当者が変わっても実行できる状態にしておくことも、運用設計の一部です。
監視ではCPUやメモリ以外の指標も見る
PostgreSQLの監視では、サーバーのCPU使用率やメモリ使用量だけを見ていても十分ではありません。
データベース固有の状態を把握する必要があります。
たとえばクエリの実行時間、接続数、トランザクション数、ロック待ち、キャッシュヒット率、ディスク使用量、レプリケーション遅延などです。
特に重要なのは、問題が発生してから確認するのではなく、異常の兆候を早い段階で検知できるようにすることです。
ディスク容量が少しずつ減っている、特定のSQLだけ実行時間が伸びている、レプリケーションの遅延が徐々に大きくなっている、といった変化を継続的に観測できれば、障害になる前に対策できる可能性があります。
ログについても、収集するだけではなく分析できる状態にしておきます。
遅いクエリやエラーを追跡できるようにしておけば、アプリケーション側の問題なのか、SQLの問題なのか、データベースやインフラの問題なのかを切り分けやすくなります。
運用では「監視している」ことよりも、「異常を検知して原因を調査できる」ことが重要です。
セキュリティと権限設計を後回しにしない
データベースにはユーザー情報や業務データなど、重要な情報が保存されることがあります。
そのため、PostgreSQLの導入時には権限設計も早い段階で決めておきたいところです。
アプリケーションが使用するDBユーザーに必要以上の権限を与えず、管理者用のアカウントと用途を分離するなど、最小権限の考え方を適用します。
また、接続元の制御、認証方式、通信経路の暗号化、バックアップデータの保護なども確認が必要です。
開発環境では簡単な設定で済ませていても、本番環境ではアクセス経路や認証情報の管理方法を明確にします。
パスワードなどの認証情報をソースコードに直接書かないことも基本的な対策です。
PostgreSQLのバージョンアップと保守計画を考える
PostgreSQLは導入したらそのまま何年も使い続けるものではありません。
メジャーバージョンやマイナーバージョンの更新、OSや周辺ライブラリとの互換性などを考慮し、継続的に保守する必要があります。
特に大規模システムでは、バージョンアップに伴う停止時間やアプリケーションへの影響を事前に評価しておくことが重要です。
検証環境を用意して、新しいバージョンで主要なSQLやバッチ処理、アプリケーションのテストを実施します。
そのうえで、本番環境への適用手順、ロールバック方法、作業時間帯などを決めておけば、更新作業のリスクを抑えやすくなります。
このように考えると、PostgreSQLの導入は単にサーバーへインストールする作業ではありません。
データモデル、SQL、インデックス、接続管理、バックアップ、監視、セキュリティ、バージョンアップまでを一つの運用設計として考える必要があります。
特に大規模システムでは、「正常に動く構成」ではなく「問題が起きても復旧できる構成」を目指すことが重要です。
ここまで設計と運用の注意点を整理すると、次に気になるのは、実際の大規模システムでPostgreSQLをどのような構成にすればよいのかという点でしょう。
次は、プライマリとスタンバイの構成やレプリケーション、バックアップ、監視などを含め、PostgreSQLを大規模システムへ導入する際の具体的な構成と運用方法を見ていきます。
PostgreSQLを大規模システムへ導入する際の構成と運用方法
大規模システムでPostgreSQLを採用する場合、データベースサーバーを1台用意してアプリケーションから接続するだけでは、十分な可用性や障害耐性を確保できないことがあります。
重要なのは、通常時の性能だけではなく、サーバー障害やネットワーク障害、急激なアクセス増加、データ容量の増大といった状況まで想定して構成を設計することです。
特に確認したいのが、どこを単一障害点にしないかという考え方です。
PostgreSQL本体だけを冗長化しても、アプリケーションサーバー、ロードバランサー、ストレージ、ネットワークなどに単一障害点が残っていれば、システム全体としての可用性は高まりません。
データベースをシステム全体の一部として捉え、アプリケーションからバックアップまでを一つの構成として考える必要があります。
基本構成はプライマリとスタンバイを分ける
大規模システムでよく検討されるのが、PostgreSQLのプライマリとスタンバイを分ける構成です。
プライマリでは基本的な書き込み処理を受け付け、スタンバイへWALを転送することでデータの複製を行います。
プライマリに障害が発生した場合には、スタンバイを昇格させることでサービスを復旧できる構成です。
この構成のポイントは、単にサーバーを2台にすることではありません。
どのタイミングでフェイルオーバーするのか、誰が判断するのか、アプリケーションは新しいプライマリへどう接続するのかまで設計する必要があります。
障害時に人間が手作業で設定を変更するのか、自動化された仕組みを利用するのかによっても、復旧までの時間や運用上のリスクは変わります。
また、スタンバイを用意しただけでバックアップが不要になるわけではありません。
レプリケーションは主に障害時の可用性を高める仕組みであり、誤ったSQLによるデータ削除や論理的なデータ破損から過去の状態へ戻す用途とは性質が異なります。
レプリケーションとバックアップは役割を分けて考えることが重要です。
同期レプリケーションと非同期レプリケーションを使い分ける
PostgreSQLのレプリケーション構成では、データをどの程度確実に複製してから処理を完了させるかという点も重要です。
同期レプリケーションでは、指定したスタンバイ側への反映を待ってからトランザクションを確定させる構成を取れます。
一方、非同期レプリケーションではプライマリ側の処理を優先できるため、レイテンシを抑えやすい反面、障害発生時に最新の更新がスタンバイへ届いていない可能性があります。
どちらを選ぶべきかは、システムが許容できるデータ損失と性能要件によって決まります。
たとえば、多少のデータ損失を許容してでも書き込み性能を優先したいシステムと、決済情報などについて極力データ損失を避けたいシステムでは、求められる構成が異なります。
ここでRPOを明確にしておくと、レプリケーション方式を検討しやすくなります。
ただし、同期方式にすればすべての障害に強くなるわけでもありません。
スタンバイ側の障害やネットワーク遅延がプライマリの書き込み処理へ影響する可能性もあります。
可用性を高めるための仕組みが、通常時の性能や可用性を別の形で低下させることもあるため、システム全体でトレードオフを評価する必要があります。
読み取り負荷はリードレプリカで分散する
大規模システムでは、書き込み処理だけでなく読み取り処理の増加も大きな課題になります。
ユーザー数が増えれば、商品検索、画面表示、履歴参照、レポート生成など、多数のSELECTが発生します。
すべての読み取りをプライマリへ集中させると、書き込み処理と読み取り処理が同じリソースを奪い合う可能性があります。
そこで、読み取り専用のスタンバイを活用し、参照処理を分散する方法があります。
いわゆるリードレプリカとして利用する構成です。
アプリケーション側で読み取り先を分けることで、プライマリの負荷を軽減できる場合があります。
ただし、レプリカには反映遅延が発生する可能性があります。
書き込んだ直後のデータを必ず読み取る必要がある処理をレプリカへ送ると、期待したデータがまだ反映されていないケースも考えられます。
そのため、すべてのSELECTを機械的にレプリカへ送るのではなく、処理ごとに整合性要件を確認することが重要です。
バックアップは別系統で用意する
大規模システムでは、バックアップを「取得しているか」だけでなく、「どこへ保存し、どの時点まで戻せるか」まで設計します。
データベースと同じサーバーや同じストレージだけにバックアップを保存していると、その基盤自体に障害が発生した場合、バックアップも同時に失われる可能性があります。
そのため、バックアップデータを別のストレージや別の障害ドメインへ保存する構成を検討します。
クラウド環境であればオブジェクトストレージなどを利用する方法もあります。
さらに、バックアップの世代管理や保存期間を決め、必要に応じてポイントインタイムリカバリを実現できるようにします。
ここでも重要なのはリストアテストです。
バックアップ処理が成功したというログだけを確認するのではなく、実際に別環境へ復元し、アプリケーションが利用できる状態まで戻せることを確認します。
復旧手順を定期的に訓練しておけば、障害発生時に担当者が手順を思い出すところから始める必要がありません。
監視とアラートで異常を早期に検知する
大規模環境では、PostgreSQLを稼働させるだけでなく、状態を継続的に観測する仕組みが必要です。
監視対象としてはCPUやメモリだけでなく、DB接続数、アクティブなクエリ、クエリ実行時間、ロック待ち、トランザクション数、ディスク容量、WALの生成量、レプリケーション遅延などが挙げられます。
特に注意したいのがディスク容量です。
データそのものが増えるだけでなく、WALやログ、一時ファイルなどによってストレージ使用量が増える場合があります。
容量不足はデータベースの正常な処理を妨げる可能性があるため、現在の使用量だけではなく、増加速度も監視したいところです。
また、アラートは多ければよいわけではありません。
頻繁に発生するものの対応が不要な通知が大量に届くと、本当に重要な障害を見落とす可能性があります。
どの状態なら緊急対応が必要なのか、どの状態なら翌営業日の確認でよいのかを整理し、運用担当者が判断しやすい監視設計にします。
障害対応は平常時から手順化しておく
大規模システムの運用で差が出やすいのが、障害発生時の対応です。
プライマリが停止した場合、スタンバイの状態を確認し、必要に応じて昇格させ、アプリケーションの接続先を切り替えるといった作業が必要になります。
ここを担当者の経験や記憶だけに依存すると、障害時の判断が遅れる可能性があります。
そこで、障害パターンごとに対応手順を作成しておきます。
たとえば、プライマリ障害、レプリケーション遅延、ディスク容量不足、長時間クエリ、ロック競合など、それぞれについて確認項目と対応方法を整理します。
さらに、実際に障害を想定した訓練を行い、手順どおりに復旧できるかを確認します。
これは単なる運用マニュアルではありません。
復旧手順を実際に試すことで、設計段階では見つからなかった問題が明らかになることがあります。
フェイルオーバー後にアプリケーションが接続先を切り替えられない、バックアップの復元に想定以上の時間がかかる、といった問題は、本番障害が起きる前に発見したいものです。
構成変更と性能改善を継続する
PostgreSQLの構成は、一度決めたら終わりではありません。
サービスが成長すればデータ量やアクセス数が増え、当初は十分だったCPUやメモリ、ストレージ性能が不足することがあります。
また、アプリケーションの機能追加によって新しいSQLが増え、以前とは異なる負荷パターンになることもあります。
そのため、監視データやログをもとに定期的なレビューを行います。
遅いクエリが増えていないか、インデックスが適切に利用されているか、ストレージ容量に余裕があるか、レプリケーション遅延が発生していないかなどを確認します。
必要であればSQLやインデックス、ハードウェア構成、レプリカ数などを見直します。
大規模システムにおけるPostgreSQLの運用は、最初に完璧な構成を作ることよりも、観測して、問題を発見し、検証して、改善するサイクルを回すことが重要です。
設計、監視、バックアップ、障害訓練、性能改善を個別の作業として扱うのではなく、一つの運用サイクルとして考えることで、長期的な安定性を確保しやすくなります。
ここまで見てきたように、PostgreSQLはトランザクションや高度なSQL、レプリケーション、拡張機能などを活用できる一方、安定運用には適切な設計と継続的な管理が欠かせません。
最後に、これまでの内容を整理し、大規模システムのデータ管理を安定させるためにPostgreSQLをどのように活用すればよいのかをまとめます。
PostgreSQLで大規模システムのデータ管理を安定させるために
ここまで、PostgreSQLが大規模システムのデータ管理に向いている理由から、性能、トランザクション、レプリケーション、拡張性、MySQLとの比較、さらに設計や運用時の注意点まで見てきました。
こうして整理すると、PostgreSQLの価値は単に「高機能なデータベースである」という点だけではありません。
データの正しさ、処理性能、可用性、拡張性、そして運用のしやすさを一つの基盤で考えられることが重要なポイントです。
大規模システムでは、ユーザー数やデータ量が増えるにつれて、データベースに求められる条件も変化します。
最初は数千件だったデータが数年後には数億件になり、単純な検索だけだった処理に複雑な集計や分析が追加されることもあります。
さらに、サービス停止が許容されない場合には、障害発生時の復旧方法まで含めた設計が必要です。
こうした変化を見越してデータベースを選び、運用方法を設計することが、長期的な安定性につながります。
PostgreSQL導入で重要なのはデータベース単体ではなく全体設計
PostgreSQLを導入するときに最初に意識したいのは、データベースだけを独立した製品として考えないことです。
アプリケーション、ネットワーク、ストレージ、バックアップ、監視、認証など、さまざまな要素が連携して一つのシステムを構成しています。
PostgreSQLの性能が十分でも、アプリケーションが大量の不要なSQLを発行していれば、システム全体としては安定しません。
逆に、データベース側に適切なインデックスや制約を設定し、アプリケーション側でトランザクションを適切に管理すれば、データの整合性と性能を両立しやすくなります。
大規模システムでは、どこか一つの技術だけで問題を解決しようとするのではなく、各レイヤーの役割を明確にすることが重要です。
特にデータモデルは後から変更するコストが大きくなりやすい部分です。
主キーや外部キー、NULLの扱い、データ型、テーブル間の関係などを早い段階で整理しておくことで、将来的な機能追加やデータ量の増加にも対応しやすくなります。
最初に考えるべきなのは、「どのデータを保存するか」だけではありません。
「どのように更新され、どのように検索され、どの程度の期間保持されるのか」まで考える必要があります。
性能はインデックスとSQLだけでなく運用まで考える
大規模システムの性能問題というと、まずインデックスやSQLが注目されます。
もちろん重要ですが、それだけで十分ではありません。
データ量の増加、同時接続数、メモリ、ディスクI/O、バックグラウンド処理、バッチ処理など、複数の要因が組み合わさってデータベースの性能を決めます。
そのため、導入後も継続的に性能を観測する必要があります。
実行時間の長いSQLを確認し、実行計画を分析し、必要に応じてインデックスやクエリを見直します。
さらに、アクセス数が増えた場合には、リードレプリカによる読み取り負荷の分散や、アプリケーション側のキャッシュなども検討できます。
ただし、性能改善では「速くすること」だけを目的にしないことも重要です。
キャッシュを増やせばメモリ消費が増え、インデックスを増やせば書き込みコストが増えます。
レプリカを増やせば運用対象が増え、構成が複雑になる可能性があります。
つまり、性能改善にもトレードオフがあります。
計測結果をもとにボトルネックを特定し、必要な箇所だけを改善する姿勢が合理的です。
データの整合性と可用性を両立させる
大規模システムでは、処理速度と同じくらいデータの正しさが重要です。
注文、決済、在庫、ユーザー情報など、複数のデータが関連する処理では、一部だけ更新される状態を避ける必要があります。
PostgreSQLのトランザクションや各種制約を活用すれば、こうしたデータ整合性をデータベース側でも担保できます。
一方で、正しいデータを保持していても、データベースが停止してサービスを利用できなければ問題になります。
そこでレプリケーションやフェイルオーバー、バックアップなどを組み合わせ、障害に備えます。
ここで忘れてはいけないのが、それぞれの仕組みには役割の違いがあることです。
レプリケーションは可用性向上や読み取り分散に利用できますが、誤操作によるデータ削除などをそのまま解決するものではありません。
バックアップやポイントインタイムリカバリなど、別の仕組みも必要になります。
どこまで障害に耐えられる構成が必要なのかは、システムの要件によって異なります。
許容できるデータ損失をRPO、復旧までに許容される時間をRTOとして整理すると、必要なバックアップ頻度やレプリケーション方式、復旧手順を具体化しやすくなります。
監視と復旧訓練が長期的な安定運用を支える
システムの安定性は、障害が一度も起きないことだけで決まるわけではありません。
現実のシステムでは、ネットワーク障害、ディスク容量不足、想定外のクエリ、アプリケーションの不具合など、さまざまな問題が発生します。
重要なのは、問題を早期に検知し、影響を抑えながら復旧できることです。
そのため、CPUやメモリだけでなく、DB接続数、長時間クエリ、ロック待ち、ディスク使用量、WAL、レプリケーション遅延などを継続的に監視します。
異常を検知したときに誰が対応するのか、どの指標を基準に判断するのかまで決めておくと、障害対応を属人化しにくくなります。
さらに重要なのが復旧訓練です。
バックアップを取得していても、本当に復元できるかは実際に試してみなければ分かりません。
スタンバイへの切り替え、バックアップからのリストア、アプリケーションの接続先変更などを定期的に検証しておけば、設計上の問題を本番障害の前に発見できます。
運用手順を文章に残すだけでなく、実際に実行して確認することがポイントです。
システムの成長に合わせてPostgreSQLも改善する
大規模システムでは、導入時点の最適解が数年後にも最適とは限りません。
ユーザー数、データ量、アクセスパターン、アプリケーションの機能は変化します。
したがって、PostgreSQLの運用も固定されたものではなく、継続的に見直していく必要があります。
たとえばデータ量が増えれば、テーブルやインデックスの設計を見直す必要が出てきます。
アクセス数が増えれば、接続管理や読み取り負荷の分散が課題になるかもしれません。
さらにデータの保持期間が長くなれば、アーカイブやパーティショニングなどを検討する場面もあります。
重要なのは、問題が顕在化してから慌てて対応するのではなく、監視データや利用状況から将来のボトルネックを予測し、段階的に改善することです。
PostgreSQLには多くの機能がありますが、すべてを最初から導入する必要はありません。
必要な機能を見極め、実際の要件に合わせて採用することが、シンプルで保守しやすい構成につながります。
高機能であることと、複雑な構成にすることは同じではありません。
PostgreSQLを「導入して終わり」にしない
PostgreSQLを大規模システムで活用するうえで、最も意識したいのは導入をゴールにしないことです。
データベースはアプリケーションとともに成長し、データ量やアクセス数に応じて設計や運用を変えていく必要があります。
安定したデータ管理を実現するためには、次のような視点を継続的に確認します。
- データモデルと制約がシステム要件に合っているか
- SQLとインデックスが実際のアクセスパターンに適しているか
- トランザクションと接続数を適切に管理できているか
- バックアップから確実に復旧できる状態になっているか
- レプリケーションやフェイルオーバーが要件を満たしているか
- 監視によって性能劣化や障害の兆候を検知できているか
- データ量やアクセス数の増加に合わせて構成を見直せているか
これらを一つずつ確認していけば、PostgreSQLを単なるデータ保存場所ではなく、システム全体の信頼性を支える基盤として活用できます。
特に大規模システムでは、データベースの選定そのものよりも、選定したデータベースをどのような設計思想で運用し続けるかが重要です。
PostgreSQLは、トランザクションによるデータ整合性、豊富なデータ型やSQL機能、インデックスによる検索性能、レプリケーションによる可用性、拡張機能による柔軟性など、大規模なデータ管理に必要となる多くの要素を備えています。
ただし、その機能を活かすには、データモデル、アプリケーション、インフラ、監視、バックアップを含めた設計が欠かせません。
「高性能なデータベースを選べばシステムは安定する」のではなく、「要件に合ったデータベースを選び、計測し、障害に備え、継続的に改善する」ことが安定運用への近道です。
PostgreSQLを導入するときも、この視点を持って設計から運用まで一貫して考えることが、大規模システムのデータ管理を長期的に安定させるポイントになります。
コメント